

AI办公正在从“尝鲜”走向日常使用。写方案、整理资料、分析数据,越来越多职场人开始借助AI智能体(Agent)完成工作。与此同时,面对不同任务,如何搭配大模型、降低使用成本,也成为用户关注的新问题。
10月19日,网易旗下办公Agent产品LobsterAI发布《中国办公Agent用户行为报告》(9月版)。报告显示,上海、杭州成为国内办公Agent使用较为活跃的城市,其中杭州以3.2%的活跃用户占比位居全国第五。与此同时,国产大模型在用户日常办公中的应用不断深入,模型组合使用、缓存降本等趋势逐渐显现。
杭州跻身全国前五,长三角AI办公应用活跃
从地域分布来看,长三角地区表现突出。
报告显示,在办公Agent活跃用户城市Top10中,上海以4.3%的占比位居全国第二,杭州以3.2%的占比排名第五。两座城市双双进入全国前五,反映出长三角地区在AI办公应用方面的活跃程度。
作为数字经济发展较快的城市,杭州近年来持续推动人工智能技术与产业场景融合。从互联网企业到中小商家,从软件开发到日常办公,AI工具的应用场景不断拓展。
与此同时,浙江、杭州也在通过政策支持降低企业使用AI的成本。浙江积极探索算力券等支持方式,杭州则围绕算力券、智能券等政策工具,为人工智能技术应用提供支持。
随着模型调用成本下降,过去需要一定技术基础才能使用的AI工具,正逐渐进入更多普通职场人的工作流程。
近七成用户只用一个模型,重度用户开始“组队”使用
面对不同办公任务,用户究竟更喜欢使用一个大模型,还是让多个模型协同工作?
报告给出了一个有意思的答案:近七成用户日常仅使用一个模型,但在重度用户群体中,多模型搭配使用的趋势更加明显,人均使用模型数量达到2.4个。
这意味着,随着使用频率提高,部分用户已经不再满足于依靠单一模型完成所有任务,而是根据不同需求选择模型组合。
在最常见的模型搭配Top5榜单中,以DeepSeek Flash系列为基础的组合占据全部五个席位。其中,“DeepSeek Flash系列+GLM 5.3 Flash”以14.0%的占比排名第一,“DeepSeek Flash系列+V4 Pro”以12.4%紧随其后。
多模型搭配的背后,是办公Agent应用方式的变化。相比简单的问答交互,复杂办公任务往往涉及资料检索、内容生成、数据处理等多个环节,对模型能力、响应速度和使用成本提出了不同要求。
模型调用越来越便宜,缓存技术成降本关键
除了模型能力,使用成本也是影响AI办公普及的重要因素。
办公Agent在执行复杂任务时,往往需要反复读取此前的对话、文档和任务信息。如果每次都重新处理这些内容,便会产生额外的模型调用费用。
缓存技术则能够减少重复计算,让部分已处理的信息被再次利用。
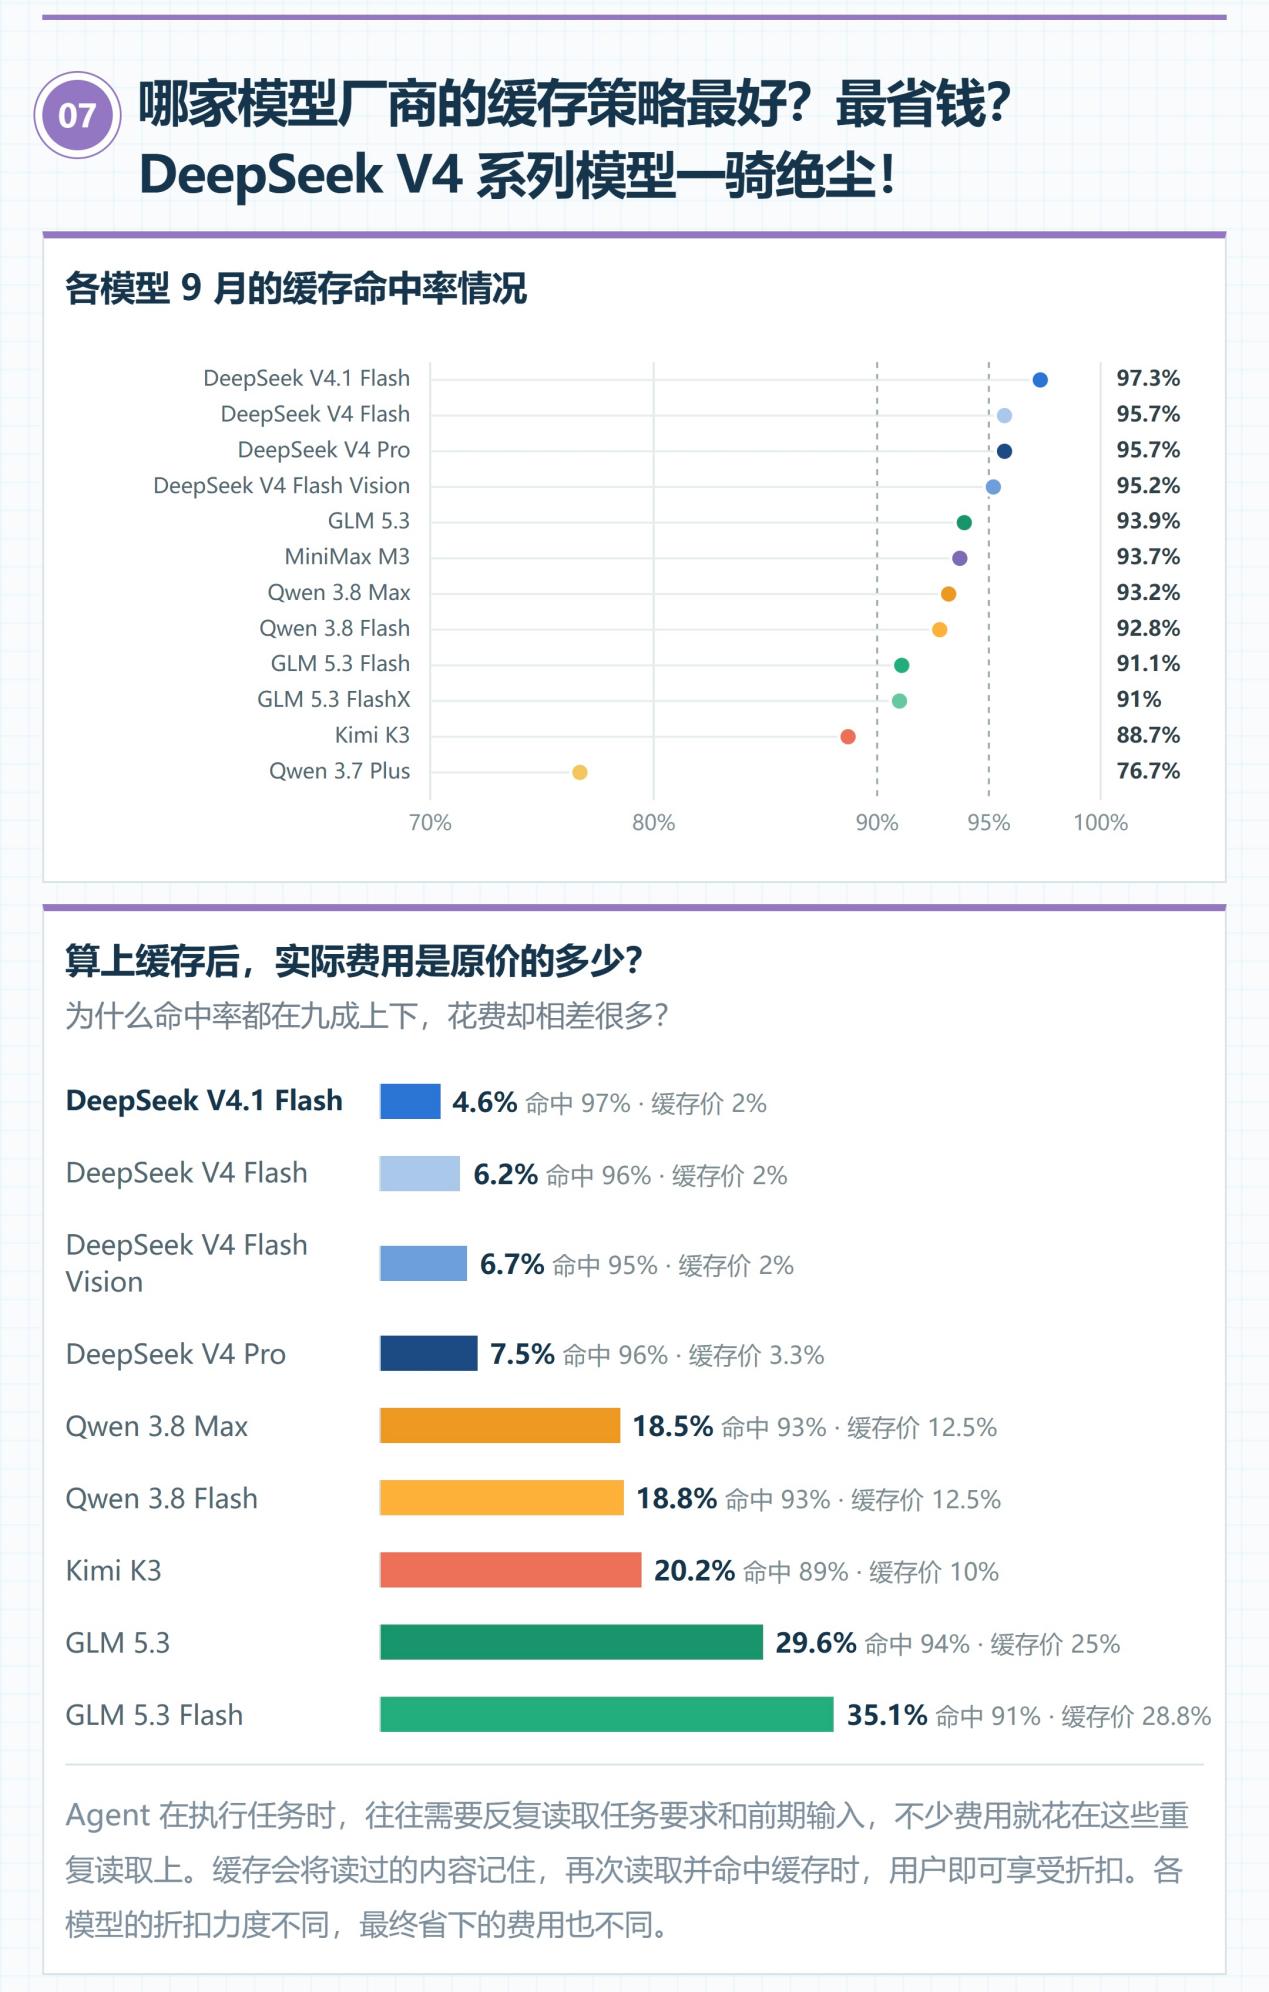
报告显示,DeepSeek V4系列9月各型号的缓存命中率均超过95%,其中V4.1 Flash达到97.3%。按照报告提供的测算口径,计入缓存后,V4.1 Flash的实际费用仅相当于原价的4.6%。
这意味着,在适合缓存复用的任务场景中,用户能够以更低成本完成多轮交互和复杂任务。不过,实际节省幅度仍取决于具体任务类型、缓存使用情况及模型计费规则。
对于需要频繁调用大模型的企业而言,模型使用成本下降,也为AI办公工具进一步推广创造了条件。
据了解,网易LobsterAI此前已完成DeepSeek V4系列多款模型的API接入与适配,为用户提供不同模型的调用选择。
网易LobsterAI相关负责人表示,从早期的“算力向头部集中”,到如今“场景全面开花、早晚高频交互”,国内办公Agent的使用正在发生变化。AI智能体不再只是开发者和技术爱好者的工具,而是逐步进入普通职场人的日常工作。
从杭州跻身活跃用户城市全国前五,到多模型组合使用日渐普遍,再到缓存技术降低调用成本,这份报告呈现出AI办公应用的新变化:用户不仅关心AI能做什么,也开始关注怎样用得更高效、更经济。
随着技术迭代和应用成本持续优化,AI办公工具能否真正融入日常工作流程、带来可量化的效率提升,将成为下一阶段值得关注的问题。