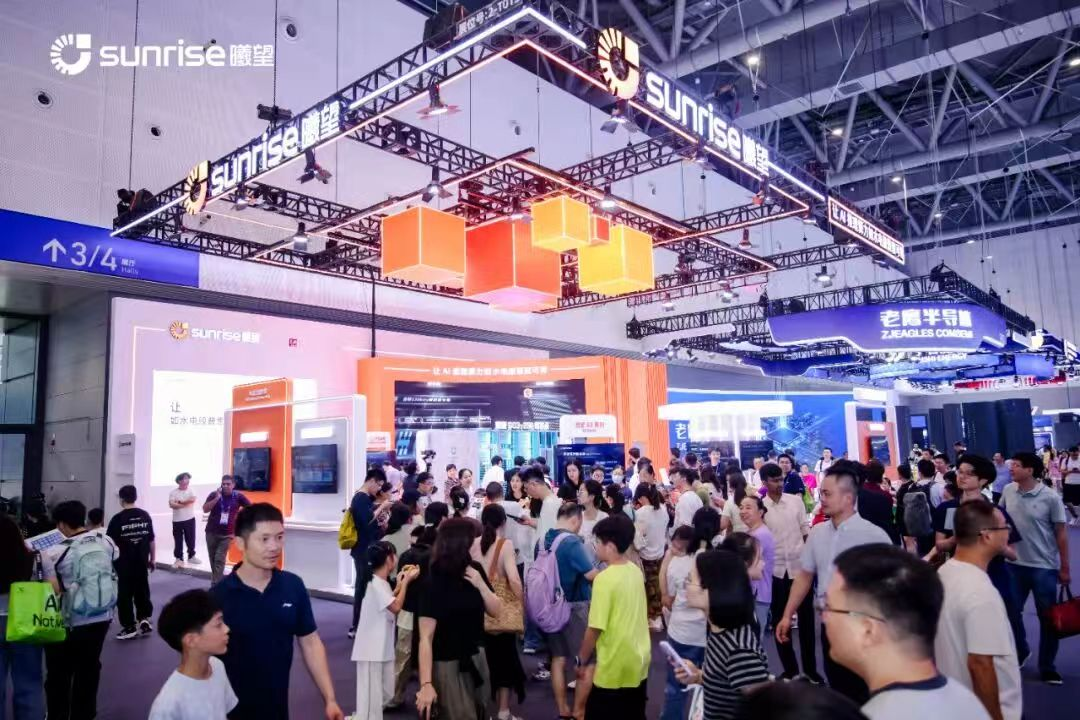


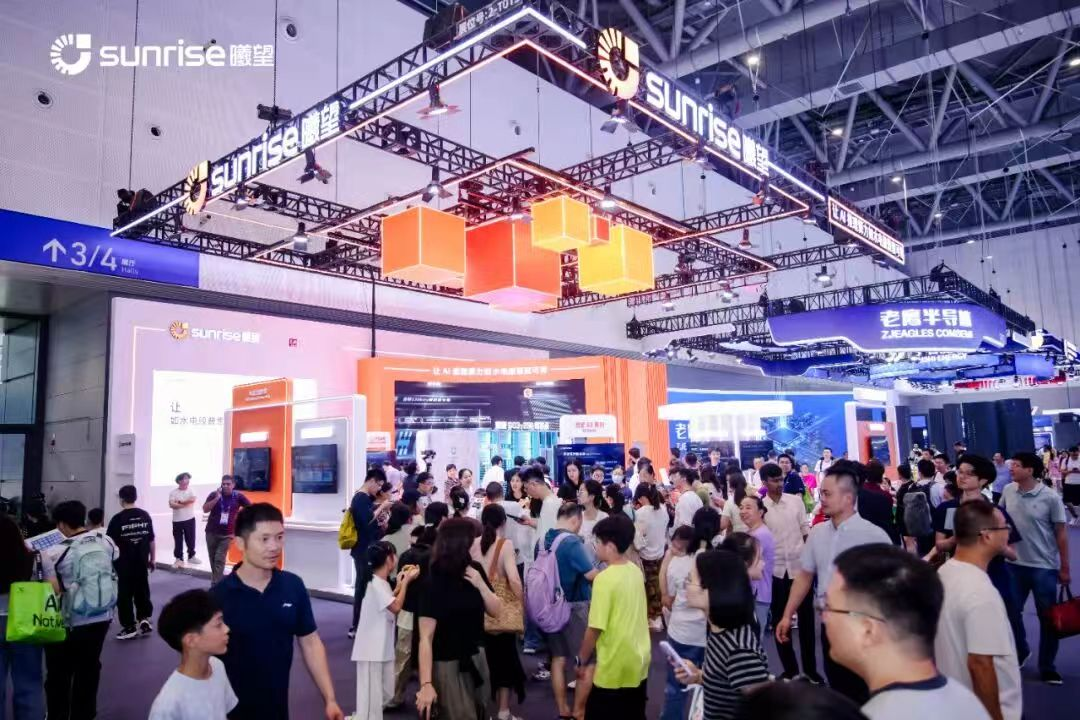
“AI的下一场仗,不是比谁更聪明,是比谁更能稳定、便宜地交付智能。”此前,在全球数字贸易博览会上,曦望新一代原生推理GPU启望S3原型和256卡超节点亮相。曦望联席CEO王湛此前在接受采访时,详细展示了token的成本结构,表示“我们要做AI产业的损益优化师,来让推理成本降低”。通俗地讲,就是帮企业把用AI的账算便宜。
Agent来了,Token账单也来了
王湛的判断是,智能体(Agent)的爆发,正在让Token消耗从“偶发”变成“持续”。“未来每个人可能拥有2至3个Agent,Agent总量有望超过人类。”
Agent和普通对话有什么区别?普通对话是“问一句、答一句”,模型给一个回答就结束了。Agent拿到的是一个目标,比如“帮我安排下周出差”,它需要自己拆步骤、反复查资料、调工具、处理意外,每一步都在消耗Token。根据2026年度印发的《智能体规范应用与创新发展实施意见》的定义,智能体是“具备自主感知、记忆、决策、交互与执行能力的智能系统”。能力多了,账单自然厚了。
现在,客户的提问方式已经变了。王湛说,过去问算力多强、显存多大;现在问业务跑不跑得起、稳不稳、便宜不便宜。“Token费用,会和水费、电费一样,出现在每一家企业、每一个人的账单上。”
2024年,曦望发现客户使用启望S2的场景绝大多数集中在推理侧。当年底,曦望把“All-in推理”写进公司战略。在国产GPU公司中,这是第一个明确放弃训推一体、专攻推理路线的选择。
2026年第一季度,中国AI推理算力需求首次超过训练算力,占比达到52%;IDC预计到2026年底升至65%。曦望这一步,踩在了拐点前面。
不做“跑分党”,做替客户算账的人
2024年,国产GPU的主流叙事还是训推一体、对标峰值性能。曦望则相反,先算客户的Token账,再倒推芯片该长什么样。
曦望联席CEO王勇有一句话,可视为曦望产品定义的底层逻辑:“我们拒绝做跑分党,不希望用benchmark来定义芯片,而是希望做帮客户赚钱的算力。”
所谓的“跑分党”,是指在芯片和硬件领域过度依赖,甚至唯基准测试分数来评价或定义芯片价值的人或厂商,忽略了理论峰值性能与真实应用体验之间的巨大鸿沟。
而S3的架构取舍,几乎每一步都在兑现这句话:砍掉训练相关模块,放弃昂贵的高带宽HBM,把省下来的晶体管面积和功耗预算,集中投向推理。
“当Token变成可计价的商品,推理GPU就是在为这个商品降低成本。”曦望要做的不是“又造一个芯片”,而是重写AI产业的成本结构。
怎么降?分子做减法,分母做加法
王湛认为,降本可以拆成一道算术题:
单位Token成本=(硬件摊销成本+算力运行成本+系统运维成本)÷Token产出量
“降低分子,提高分母。”王湛讲得很朴素。
分子端重要的一刀在存储。启望S3是国内首款用LPDDR6替代传统HBM的GPU方案。HBM带宽高但贵,LPDDR带宽低一些,但价格低、供应广。推理场景对容量的敏感度高于带宽,这笔账算下来更划算。配合精简训练模块释放的芯片面积,软件兼容主流AI生态,客户迁移成本也计入这笔账。
分母端靠系统效率。S3原生支持FP4到FP16精度切换,显存容量比上一代大幅增加,结合高速互联和分层存储,把每一份硬件投入能产出的Token推上去。企业测算显示,相比上一代S2,S3推理性能提升约5倍,单位Token推理成本下降约90%。
单卡之上还有系统级的账。现场展示的256卡超节点,通过高速互联把256张GPU组织成一台“超大GPU”协同工作,可承载万亿参数级多模态MoE模型。王湛叫它“推理巨兽”。大模型到了万亿参数级别,用户需要的不是一颗好芯片,而是一套能稳定输出Token的系统。
只有单位Token的成本被真正打下来,智能体才可能从少数头部企业的试验场,走进千行百业的日常账单。如今,曦望正在改写中国AI产业的损益表。