

9月22日,2026云栖大会在杭州国际博览中心开幕。紫光股份旗下新华三集团以“打造Token极致性价比”为主题亮相大会核心展区,集中展示覆盖算、网、存等关键环节的智算新品与技术成果,呈现面向大模型训练、推理和AI应用的新一代基础设施能力,推动智算基础设施加速从规模扩张转向整体效能提升。
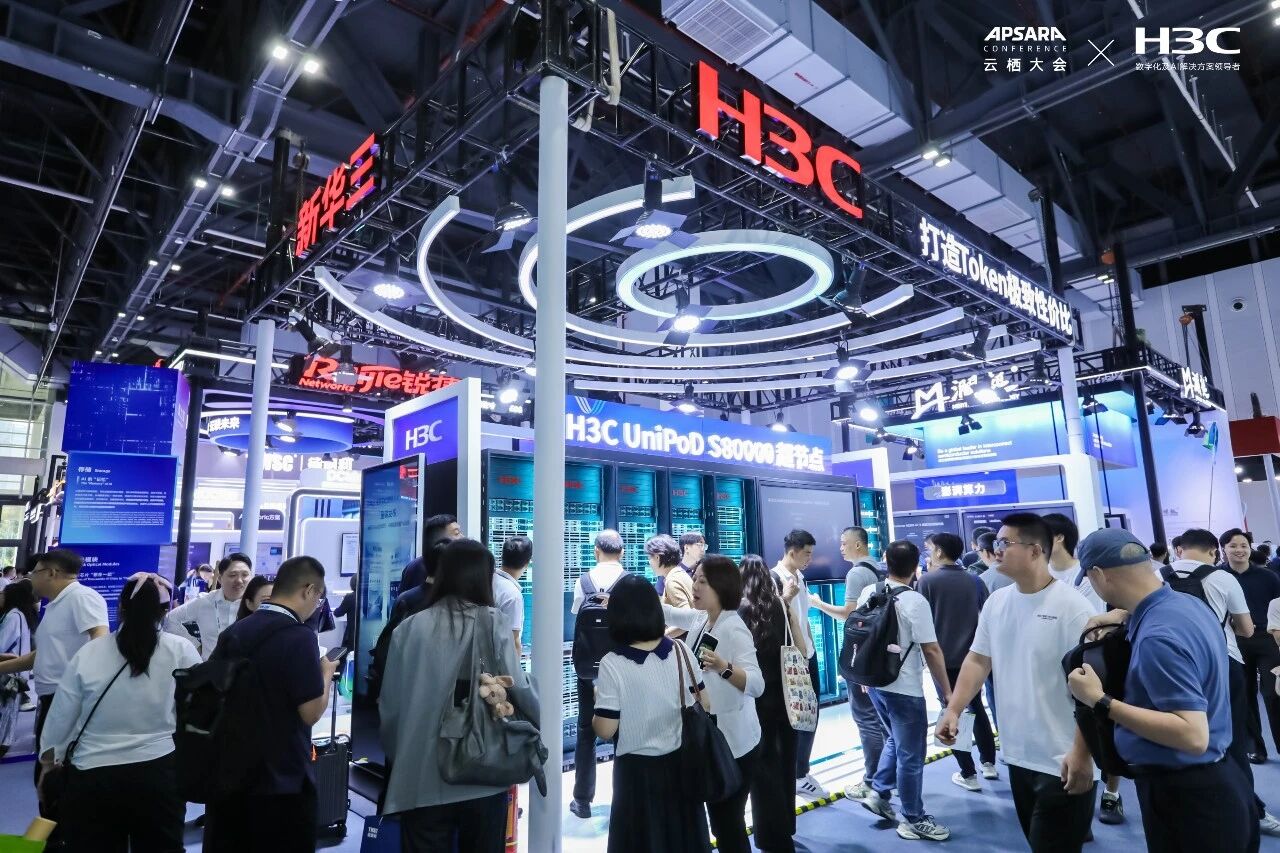
随着Agentic AI进入规模化落地阶段,万亿级Token服务成为行业刚需,但盲目堆叠GPU带来的算力空转、通信拥堵与故障频发,正让企业陷入“规模越大、成本越高”的恶性循环。2026云栖大会期间,新华三集团以“打造Token极致性价比”为核心主题,系统展示面向Token高效生产与传输的AI基础设施全栈能力。
面向万亿参数模型训练与推理需求,新华三UniPoD S80000超节点以超高密度、极致互联、全栈优化、多元开放为核心能力,构建面向大规模AI训推的算力底座。产品支持从32卡至1024卡灵活扩展,并可进一步弹性扩展至16384卡规模,兼容国内主流品牌的CPU、GPU、NPU、DPU等异构算力,打破资源壁垒,实现“一云纳百算”。
新华三超节点并非简单堆叠GPU,而是通过算-网-存-云-安-维全栈能力的深度协同,让算力从“规模叠加”走向“极致效能”。围绕算力组织、数据供给、互联通信、资源调度与运维管理等关键环节进行系统优化,打通从芯片到应用的效率链路,实现训练性能提升70%、推理性能提升3倍,最大化释放基础设施整体效能,提升Token产出能力。
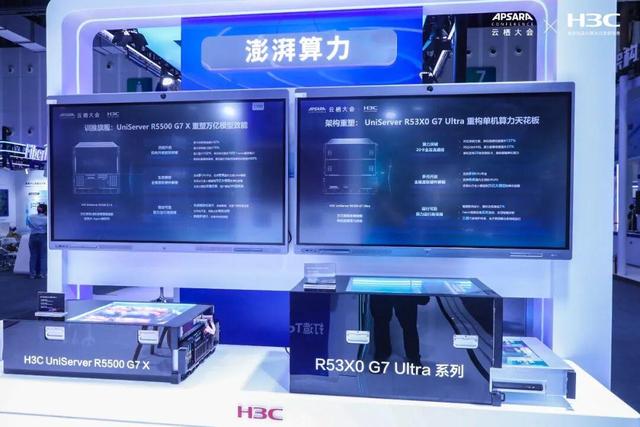
本次大会,新华三集中展示了多款面向不同AI负载的服务器新品。其中,H3C UniServer R5500 G7 X面向超大规模AI训练,专为千亿、万亿参数大模型研发与微调打造,采用模块化解耦设计,兼容OCP OAI 2.0开放硬件标准,实现算力开放、弹性扩展与持续进化;H3C UniServer R53X0 G7 Ultra定位训推一体异构算力引擎,兼顾小规模训练与高并发推理,高效承载智能体调度与运行,适配智算中心、边缘AI、企业级AI平台等多元场景。通过不同形态、不同规格的算力协同布局,新华三让算力资源能够根据AI任务灵活匹配,在满足多样化算力需求的同时进一步提升资源利用效率。
在大规模智算集群场景下,网络已成为决定算力规模能否持续扩展、效能能否充分释放的核心变量。本次大会,新华三全景呈现了Scale-Up、Scale-Out及Scale-Across三大场景的完整智算网络产品矩阵,构建起面向智能时代的下一代网络底座。
算力决定AI速度,存力决定AI效率。本次大会,新华三重点展示UniStor X20000系列旗舰产品X20836。面向大模型训练与推理不断增长的数据规模和访问压力,X20836以全速引擎、多协议互通、XCache推理加速三大核心能力,打通从数据准备、模型训练到Token生成的存储链路,提升AI数据供给与处理效率。
除主题展台外,新华三还于9月23日上午举办重磅分论坛“打造Token极致性价比——下一代智算关键技术创新论坛”,聚焦AI Infra领域技术创新与实践分享,与产业链伙伴共探Token极致性价比的实现路径。
来自阿里云、平头哥、英特尔、Broadcom、清程极智、是石科技等知名AI企业的技术专家齐聚一堂,围绕智算基础设施的关键技术攻坚与实践成果展开深度研讨,凝聚产业合力,探寻效能跃升路径。
当前,AI产业正从比拼模型参数、硬件卡数的粗放发展阶段,加速迈向规模化商用落地的攻坚期。规模扩容之下,单纯硬件堆叠的边际效益持续递减,训推成本高昂、集群协同效率不足正成为全行业面临的共同挑战。
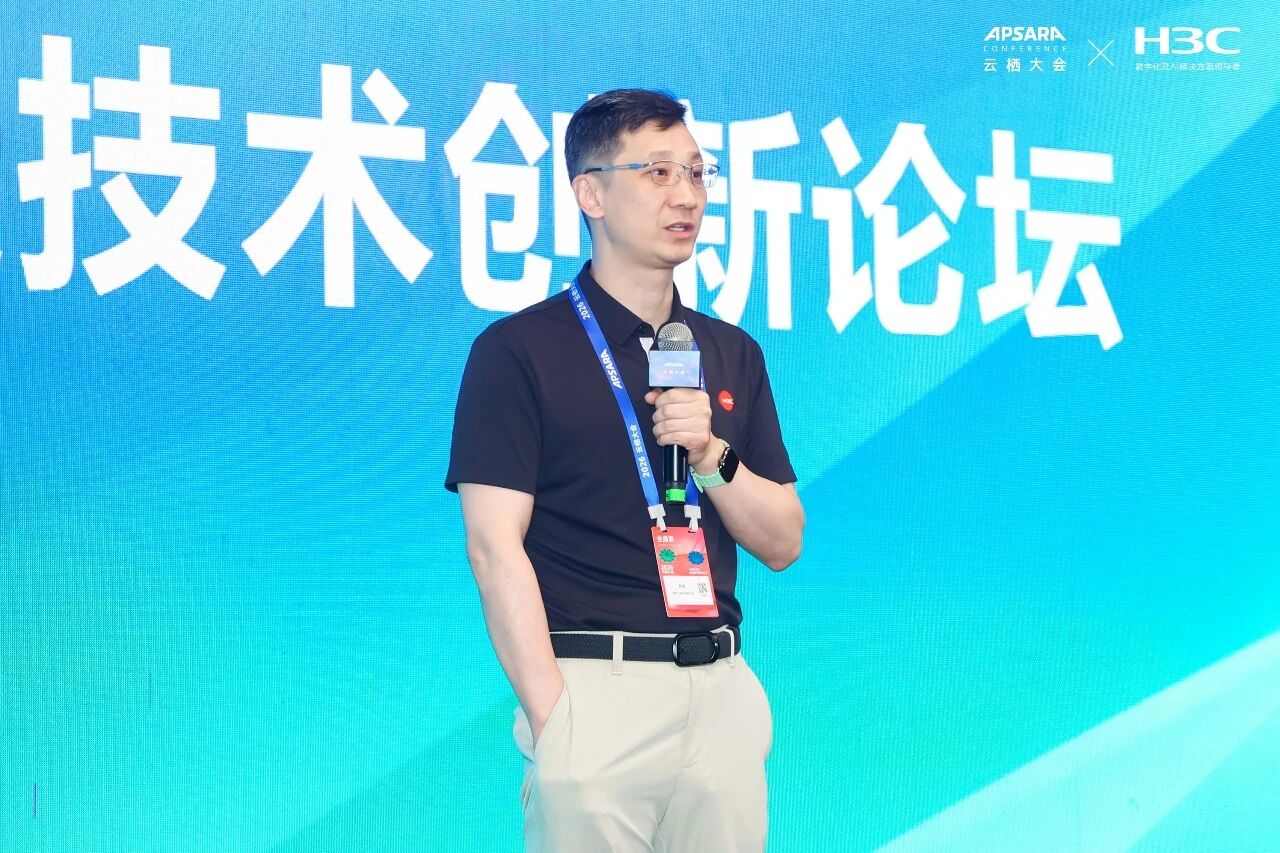
新华三集团高级副总裁、网络产品线总裁乔剡在开场致辞中指出,智算产业在发展中面临的瓶颈无法仅依靠单一硬件迭代破解,唯有通过系统级创新、全栈技术协同与产业链联动,削减全链路资源损耗,方能夯实AI产业长期发展根基。
阿里云专有云网络和安全负责人、资深技术专家张然随后发表致辞,他从云产业实践视角,阐述了智算建设与成本管控的产业思考,并呼吁产业链加强协同,共同推动大模型业务走向规模落地。
本次论坛围绕Token极致性价比这一核心主题,从超节点架构创新到整机协同优化开篇,进行算力底座的芯片层、联接层、存储层再到软件优化层的逐维拆解,全面呈现下一代智算基础设施的关键技术演进路径。
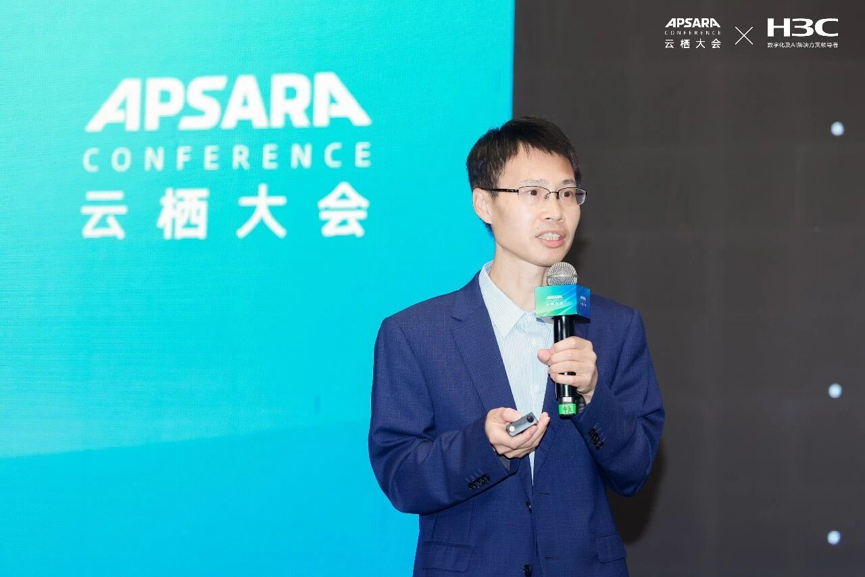
新华三集团先进技术研究部总经理朱仕银指出,超节点并非简单的算力堆叠,而是高速互联、供电散热与软件栈优化协同构成的系统工程。在Scale-Up高速互联层面,新华三在积极跟进国内外主流标准协议的同时,也在持续投入自研G-Link互连协议及技术架构创新,面向更大规模的GPU互联提升带宽、时延与可靠性;同时,在高密供电与液冷散热、训推软件优化等关键环节持续突破,通过互联架构、协议、通信软件及资源调度等协同优化,构建高带宽、低时延、高可靠的超节点算力底座,持续提升算力资源利用效率与系统整体性能。